
本篇目录
很多人想做视频号,卡在同一个地方:日更。
拆开看,做一条视频要经过这几步:找选题、找素材、下载、听懂内容、加字幕、写标题和文案。真正需要「人」的只有两件事——判断什么值得发,和加上自己的观点。其余的,都是重复劳动。
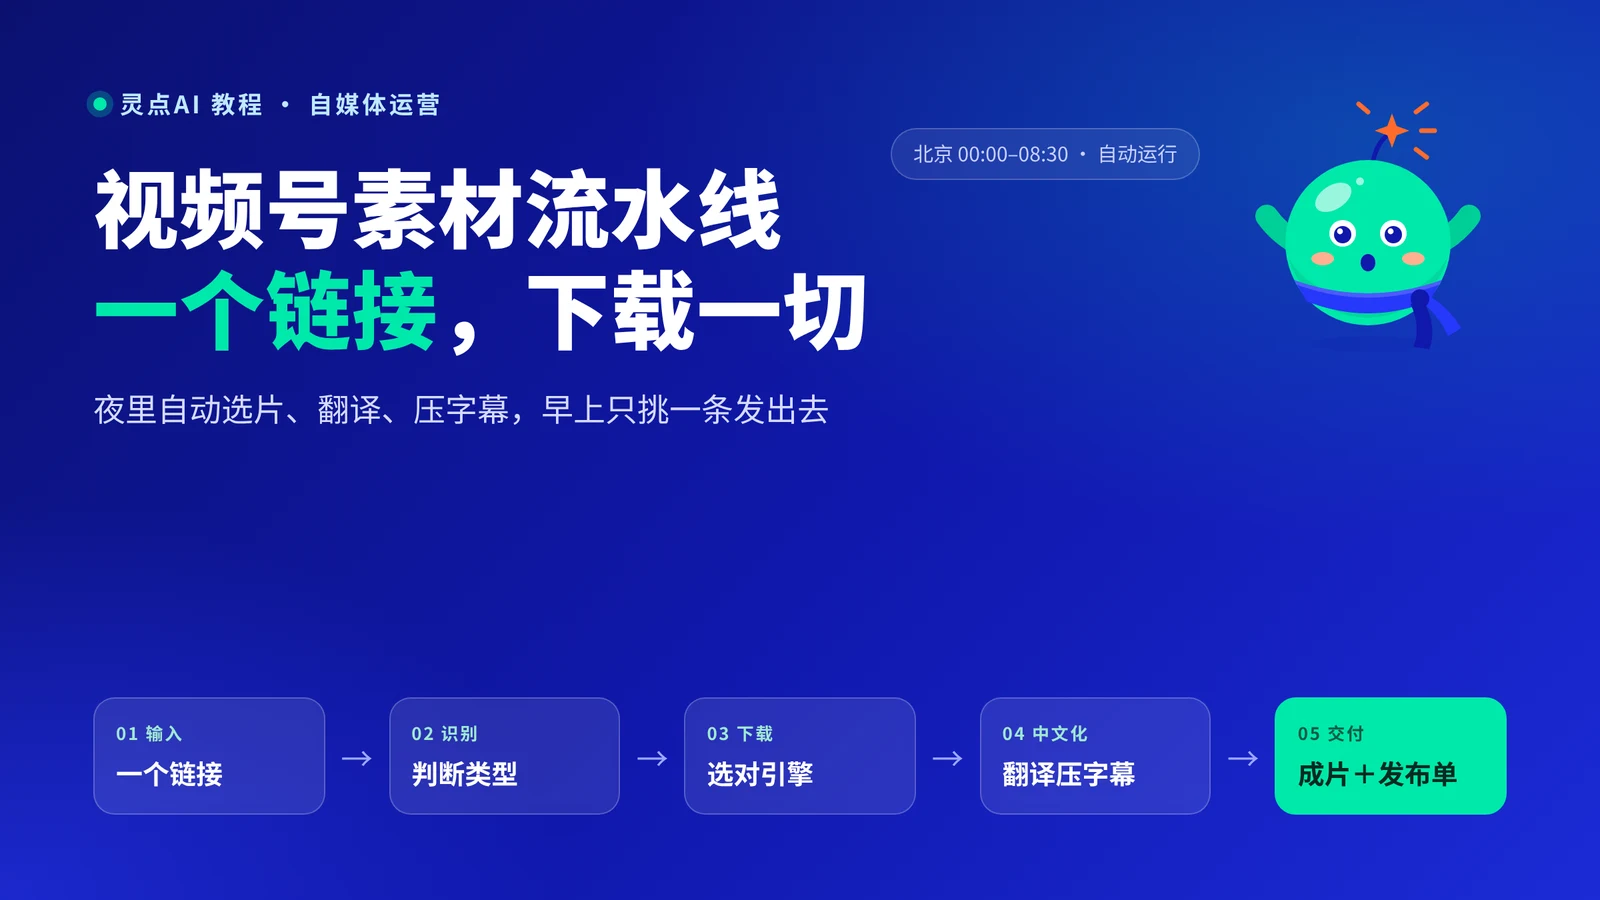
这篇教程换个思路:把重复劳动交给一条自动化的流水线,人只保留判断和创作。我们用一个开源工具 Universal Content Intake 来搭,你会看到它怎么把「一个链接」变成「一条带中文字幕、附好发布文案的成片」,以及它挑选素材背后的方法。
准备清单
- 工具:Universal Content Intake(GitHub 开源,个人非商业使用免费)
- 电脑:macOS 15 及以上(推荐 Apple 芯片),或 Windows 10 / 11
- 时间:只装下载功能几分钟;加上自动选片约 30~60 分钟
- 难度:进阶。不熟悉命令行的话,可以全程让 Claude Code、Codex 这类 AI 编程工具代装
- 可选:一个 Google 账号(自动选片用)、一个免费的 Gemini API Key(AI 判断用)
为什么值得现在做视频号
用户已经在那里。腾讯 2026 年第二季度财报显示,微信及 WeChat 合并月活跃账户数 14.39 亿;作为对比,QuestMobile 统计的抖音月活在 2026 年 3 月刚过 10 亿。视频号不需要用户下载新 App,发现页、朋友圈、聊天、公众号、搜一搜都是它的入口。
它多一条传播路径。朋友点过赞的视频会出现在你的推荐里。一条好视频除了靠算法,还能沿着熟人关系往外走。
内容还不够多。有创作者用「日活用户 ÷ 每天新发视频数」粗略估算过:抖音上每条新视频大约分到 20 个日活,视频号大约 30 个。这个数字不是官方统计,但和很多人的体感一致——抖音头部早已团队化、MCN 化,视频号的不少垂直方向还没人认真做。
所以策略很清楚:越早越好,而且要稳定更新。而稳定更新,正是一个人最难坚持的。
流水线分两层
先看全貌,再逐段拆开:
- 第一层:收集和中文化。给一个链接,自动识别是什么内容、下载、转写、翻译、压字幕。这一层单独用就很有价值,不做视频号也用得上
- 第二层:自动选片。盯住一批海外作者,夜里用数据和 AI 筛出值得做的视频,早上交给你
第一段:一个链接,下载一切
日常收集素材时,最烦的是「不同东西要用不同工具」:视频一个、网页一个、图集又一个。这个工具把它们合到了一个入口。
你只要给链接,它会依次看三样东西来判断内容类型:是哪个平台、文件扩展名是什么、服务器说自己返回的是什么,然后调用对应的下载引擎。如果你明确说了「下载这个 PDF」,它就跳过判断,直接按你说的做。
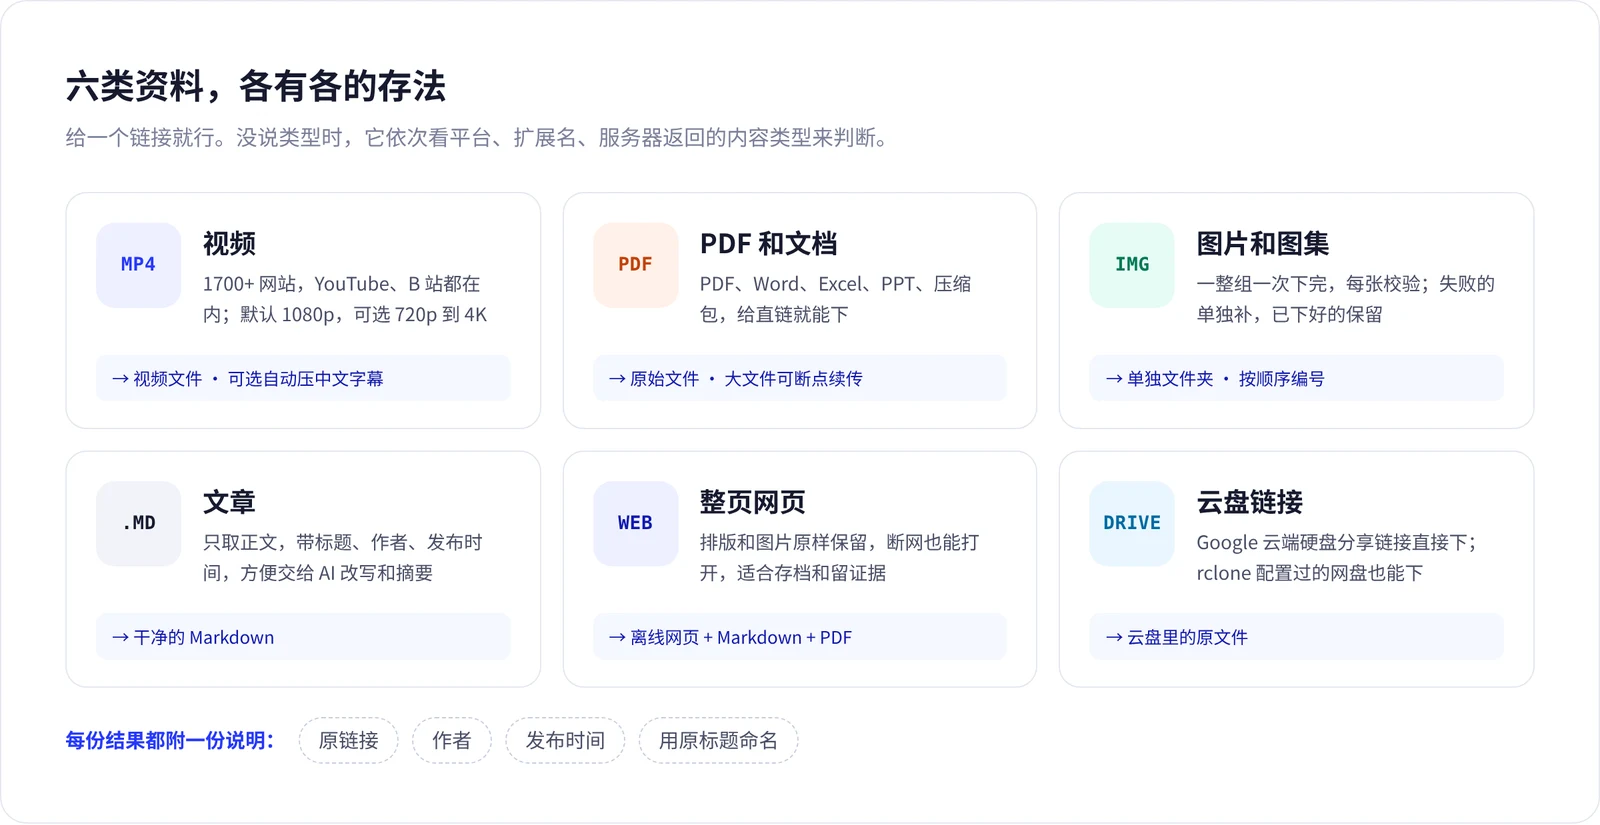
六类资料,每类都按最适合后续使用的方式保存:
- 视频:基于 yt-dlp,覆盖 YouTube、B 站等 1700 多个网站,默认 1080p
- PDF 和文档:Word、Excel、PPT、压缩包,给直链就能下
- 图片和图集:整组下载,每张校验;失败的单独补,已下好的不重来
- 文章:只保留正文,存成 Markdown,带标题、作者、发布时间
- 整页网页:同时存离线网页、Markdown 和 PDF
- 云盘:Google 云端硬盘分享链接,或用 rclone 配置过的网盘
我们最喜欢的一个细节:每份下载结果旁边都有一个说明文件,记下原链接、作者和发布时间。做内容的人都知道,三个月后想找出处、补署名时,这份记录有多值钱。
一个顺手的用法:文章存成 Markdown 之后,可以直接交给 AI 做摘要、改写成口播稿、提炼选题。下载和写作就这样连起来了。
第二段:下载完,就是中文版
海外视频要给中文观众看,还差字幕。这一段也是自动的,而且整个过程在你自己的电脑上完成,不调用收费云服务:
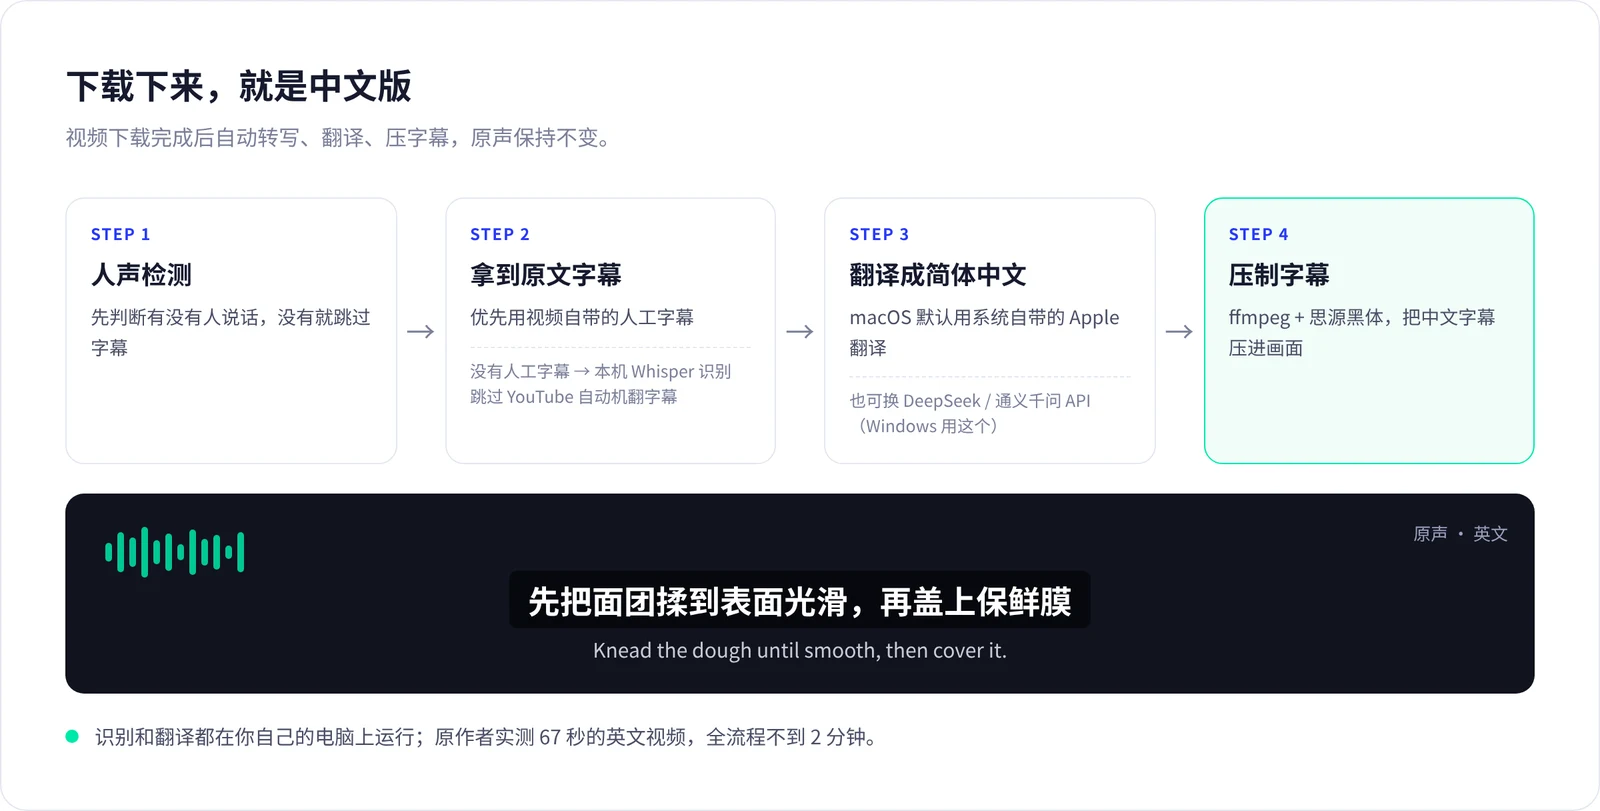
- 先检测人声:没有人说话的视频,直接跳过字幕
- 原文字幕:优先用视频自带的人工字幕;没有就用本机运行的 Whisper 模型识别。YouTube 的自动翻译字幕质量不稳,还容易触发限流,所以直接不用
- 翻译:macOS 默认用系统自带的 Apple 翻译,零成本;也可以换成 DeepSeek 或通义千问的 API,Windows 上用的就是这种方式
- 压制:ffmpeg 加思源黑体,把中文字幕压进画面,原声不动
一条一分钟左右的英文视频,从下载到压好字幕通常两分钟以内。也就是说,多做一条视频几乎没有额外成本。
动手:装好,再跑第一条
macOS 打开「终端」,依次运行:
git clone https://github.com/YIAN6557/universal-content-intake.gitcd universal-content-intakebin/uci https://example.com/report.pdfWindows 先装 Python 3.11+ 和 Git(winget install Python.Python.3.13 Git.Git),最后一行改成 bin\uci https://example.com/report.pdf。
第一次运行会问两件事:要不要开启自动选片?下载视频时要不要自动压中文字幕?都可以先选「不」,以后用 bin/uci settings 随时改。缺依赖的话,bin/uci setup doctor 会告诉你缺什么、怎么装。
更省事的方式是让 AI 编程工具替你装:
帮我安装 https://github.com/YIAN6557/universal-content-intake 。先读 README,列出需要的依赖,并标出哪些步骤必须由我本人完成。每一步执行前先告诉我要做什么。装好后运行 bin/uci setup verify 做一次验收。登录 Google、填写 API Key 这些步骤,自己在浏览器或终端里完成,不要把 Key 贴进对话。
装好以后,日常就是一行命令:
bin/uci https://www.youtube.com/watch?v=xxxxbin/uci "下载这个视频 https://www.youtube.com/watch?v=xxxx"bin/uci https://www.youtube.com/watch?v=xxxx --quality 4k --zhbin/uci https://example.com/page --type article--zh 和 --no-zh 控制这一次要不要压字幕,--to 指定保存位置,默认存在「下载」文件夹。
第三段:让数据替你选片
第一层解决了「做得出来」,第二层解决「做哪条」。
开启自动选片后,你给它一份想关注的 YouTube 作者名单。它在 Google 的云端(Apps Script 加一张 Google 表格)定时检查这些作者有没有发新视频。不需要 YouTube API Key,也没有服务器要维护。
用好时差
北京时间 00:00~08:00,恰好是美国西海岸夏令时的 9:00~17:00,海外作者最活跃的时段。你睡觉的这八个小时,正是新视频集中出现、并开始积累数据的时候。
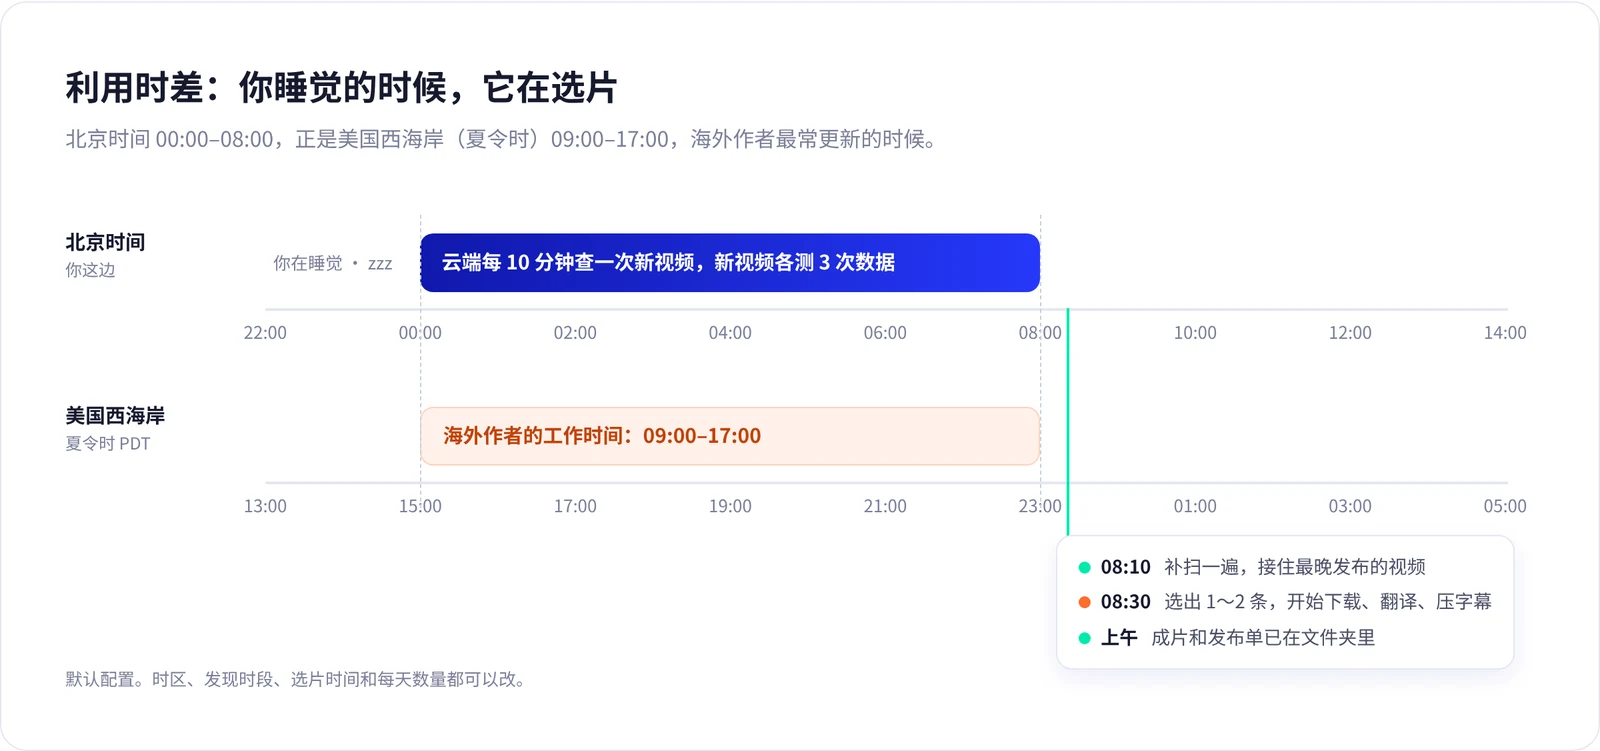
默认的节奏是:夜里每 10 分钟查一次新视频;每条新视频在发布后 30、60、120 分钟各记录一次播放和点赞;08:10 补扫一遍;08:30 选出当天最好的 1~2 条,开始下载和压字幕。这些时间都能按自己的时区和作息改。
于是你早上拿到的,是一条已经在海外跑了两小时真实数据、而中文平台上还没人发过的视频。这比凭感觉追热点踏实得多。
跟作者自己比,而不是比绝对值
判断一条视频「火没火」,最直觉的办法是看播放量。但这对小作者不公平:大号随手一发就是几十万,小作者的爆款数字上反而不显眼。
这套系统的做法是给每位作者单独定一把尺子:读取他最近 20 条视频,算出播放量和点赞率的中位数。用中位数,是因为一两条百万爆款会把平均数拉得很高,导致他的大多数新视频都被误判成「不行」;中位数代表的是他一条普通视频的水平。
然后,新视频要过两道关:
- 播放关:在 30 / 60 / 120 分钟时,播放量达到「作者播放中位数 × 对应比例」。默认比例是 2.5% / 5% / 10%,偏严格,可以按需要调低
- 点赞关:点赞率不低于作者中位数的 80%;或者播放正在加速(这一段每小时的增长比上一段多)。两个条件满足一个即可
播放关筛掉没人看的,点赞关筛掉「点开了但不认可」的标题党。而「点赞率稍低、但还在加速」的视频会被留下,因为加速通常意味着平台还在推。
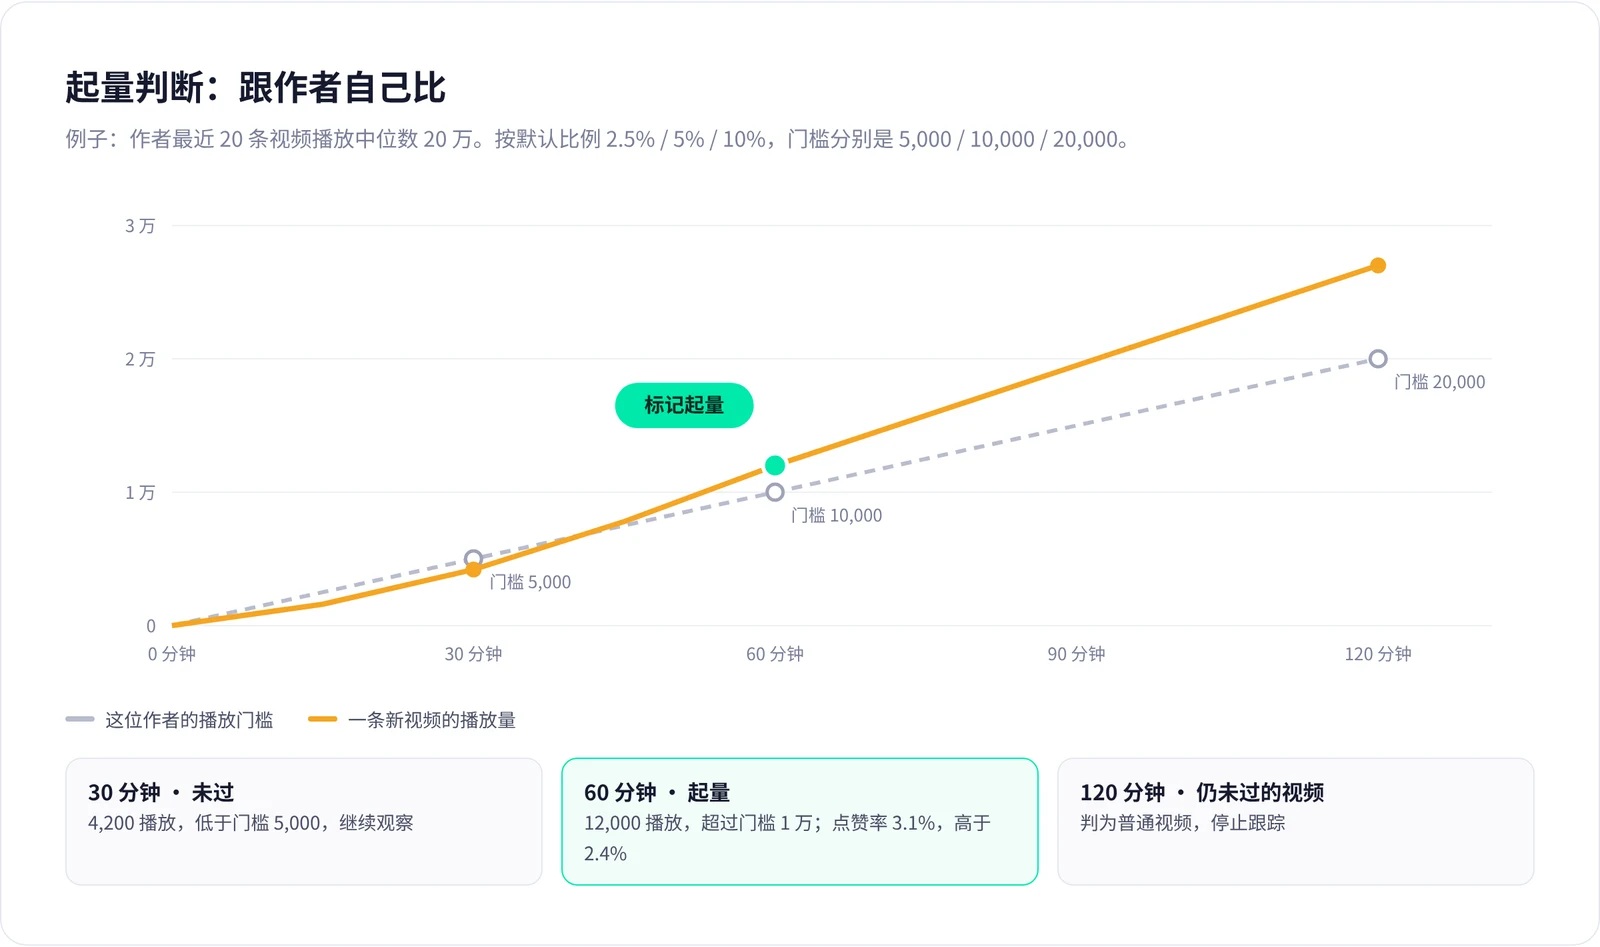
算一个例子。某作者播放中位数 20 万、点赞率中位数 3%。按默认比例,新视频 30 分钟时要有 5,000 播放,60 分钟 1 万,120 分钟 2 万,点赞率不低于 2.4%。任何一个时间点同时过两关,就标记为「起量」;到 120 分钟还没过,就不再跟踪。
系统跟踪满一位作者的 10 条新视频后,会切换成更准的「同时段对比」:直接比较他过去的新视频在同一时间点的表现。比如他的视频发布 60 分钟时一般有 4,000 播放,这条要到 6,000(1.5 倍)才算过关。这样,有的作者开局猛、有的后劲足,这种节奏差别也被考虑进去了。
最后一关:符不符合你的账号
数据好,不代表适合你。所以起量的视频还要再过两层筛选——先规则,后 AI:
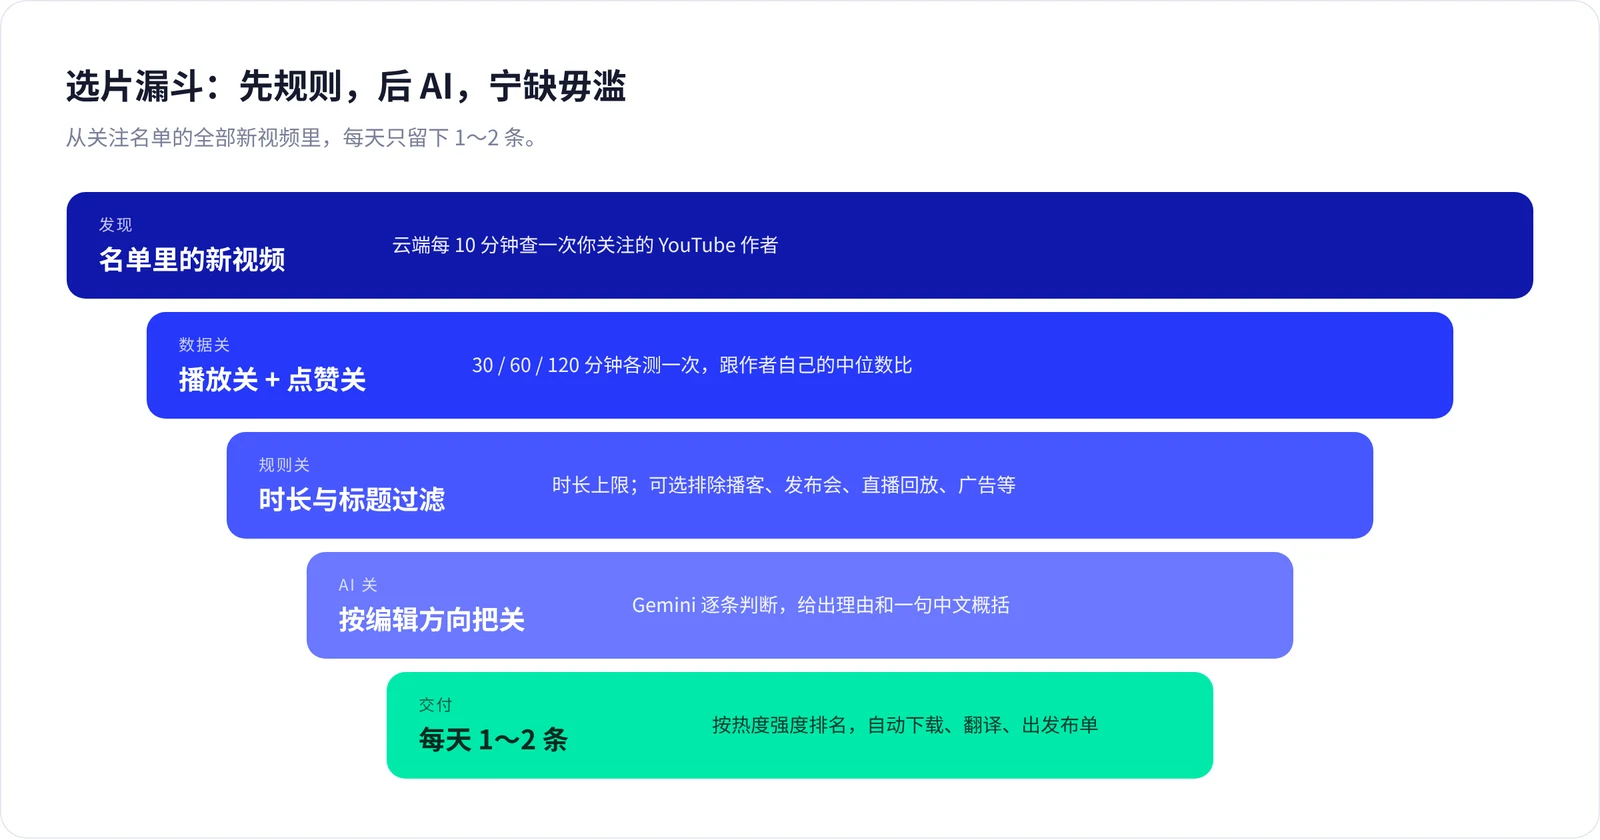
- 规则:时长上限;还可以按标题排除播客、发布会、直播回放、评测、广告等类型
- AI:你用大白话写一段「编辑方向」,Gemini 逐条判断,给出接受或拒绝的理由,并用一句中文概括视频内容
编辑方向写得越具体越好,比如:
只要有完整制作过程的家常菜视频。不要探店、不要带货、不要只展示成品的视频。换一个领域,改这段话就行。Gemini 的免费额度足够日常使用;不接 AI 也能跑,只是筛得粗一些。
如果某天没有一条视频同时满足所有条件,那天就不交付——宁可空着,也不凑数。
早上打开文件夹,你会看到什么
每条成片都附一份发布单,包括:
- 建议的标题、发布文案和话题标签
- 完整来源:原标题、作者、作者主页、原链接、发布时间、时长、字幕来源
- 入选理由:在哪个时间点、超出门槛多少
你的工作只剩最后一步,也是最重要的一步:看一遍,加上自己的观点和二次创作,再发出去。
值得借鉴的五个设计
就算你不用这个工具,下面这些思路也可以用到自己的 AI 自动化里:
- 中位数代替平均数:评估「正常水平」时,先排除极端值的干扰
- 把时差变成优势:让机器在你休息的时候工作,并等数据先替你验证
- 先规则,后 AI:硬条件交给规则,便宜、稳定;语义判断交给 AI
- 宁缺毋滥:自动化系统要有「今天不交付」的选项,否则它会制造垃圾
- 为出错而设计:断点续传和 SHA-256 校验、崩溃后任务不丢不重复、限流按 60 / 180 / 600 秒退避重试、连续失败就暂停告警、下载引擎更新失败自动回退旧版
先读这一段:版权、许可证和平台规则
版权。能下载不等于能发布。把别人的视频原样搬到自己的账号,需要事先取得原作者授权,并遵守视频号关于原创和搬运的规则。更稳妥、也更有长期价值的做法是:
- 联系海外作者,获得授权后做中文翻译版,并在视频里注明出处
- 把素材当作参考,做解说、盘点、教程,加入你自己的观点和画面
- 引用片段时只用必要的部分,并清楚标注来源
许可证。这个工具采用双许可:个人、非商业使用免费;公司、团队、为客户做项目等商业用途,需要提前取得作者的书面商业授权。如果你的账号由团队或公司运营,先读一遍仓库里的 LICENSE。
平台规则会变。发布前,留意视频号最新的内容规范。
举一反三
把「视频号」换成别的场景,这条流水线一样成立:
- 盯住几个行业博客,每天早上自动拿到中文摘要
- 收集竞品官网和更新日志,自动存档成 Markdown 和 PDF
- 把讲座、播客下载下来,自动转写成文字稿,再让 AI 整理成笔记
做法始终是同一个:让机器负责收集和初筛,人负责判断和创作。
参考与致谢
- 工具:Universal Content Intake(GitHub),安装命令和功能按 2026 年 10 月的 README 核对,如有变化以仓库为准
- 本文的部分思路来自工具作者 @EianLu 在 X 上的分享
- 数据:腾讯 2026 年第二季度业绩(东方财富网)、QuestMobile 抖音月活数据(3DM)